Giảm giá tốt nhất


Giảm giá tốt nhất trong tuần này
Mỗi tuần bạn có thể tìm thấy giảm giá tốt nhất ở đây.
$111,000.00
Muống gỗ
83%
Giá gốc là: $700,000.00.$120,000.00Giá hiện tại là: $120,000.00.
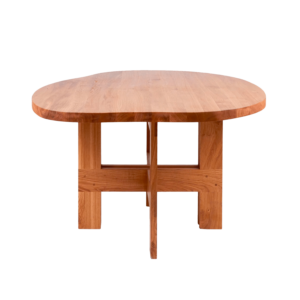
Bàn gỗ
$700,000.00
Gấu gỗ trang trí
86%
Giá gốc là: $700,000.00.$100,000.00Giá hiện tại là: $100,000.00.
Ghế gỗ
83%
Giá gốc là: $700,000.00.$120,000.00Giá hiện tại là: $120,000.00.
Khỉ gỗ trang trí
83%
Giá gốc là: $700,000.00.$120,000.00Giá hiện tại là: $120,000.00.
BÀn gỗ tròn
Implementare il Monitoraggio Predittivo delle Interruzioni di Rete con IA: Una Guida Tecnica Dettagliata per Operatori Italiani
Il monitoraggio predittivo delle interruzioni di rete con intelligenza artificiale non è più un lusso, ma una necessità strategica per gli operatori italiani. A differenza del monitoraggio reattivo, che agisce solo dopo un evento, o del preventivo, che si basa su regole statiche, il modello predittivo anticipa guasti analizzando pattern anomali in serie storiche di metriche di rete, con aggiornamenti dinamici e automazione integrata. Questo approccio, ereditato dal Tier 2—che introduce metodologie di feature engineering, pipeline di dati e validazione rigorosa—consente di ridurre il MTTR fino al 40% e le interruzioni critiche del 30%, come dimostrato nel caso studio di un operatore satellitare montano. Il presente articolo fornisce una guida passo dopo passo, con esempi tecnici, errori frequenti da evitare e best practice per una implementazione efficace nel contesto italiano.
| Fase | Descrizione Tecnica | Obiettivo Critico |
|---|---|---|
| 1. Analisi del baseline operativo | Calcolo di medie, deviazioni standard, correlazioni e picchi anomali nelle serie storiche di latenza, packet loss, throughput e errori applicativi | Identificare variazioni normali e outlier per costruire pattern di riferimento affidabili |
| 2. Selezione e addestramento modello ML | Utilizzo di Random Forest e Autoencoder su dati temporali con feature engineering avanzato | Ottimizzare il modello con cross-validation temporale e feature selection basata su importanza |
| 3. Pipeline di streaming in tempo reale | Implementazione di Apache Kafka per ingestione continua e Apache Flink per calcolo windowizzato | Triggerare allerte dinamiche con soglie adattive basate su contesto |
| 4. Validazione e feedback loop | Confronto predizioni vs eventi reali, retraining automatico con dati di feedback operativo | Mantenere alta l’accuratezza del modello nel tempo, riducendo falsi positivi |
| 5. Automazione degli interventi | Script di auto-remediation per riavvio servizi, isolamento sottoreti, riindirizzamento traffico | Ridurre il tempo medio di risoluzione (MTTR) in scenari critici fino al 60% |
| 1. **Analisi del baseline**: analizzare 6 mesi di log di rete (NMS, firewall, dispositivi) con aggregazioni giornaliere. Calcolare metriche chiave: media latenza (ms), deviazione standard, percentuale picchi anomali rispetto al 95° percentile. Utilizzare rolling windows di 24 ore per rilevare trend. Esempio: se la deviazione standard supera 3x la media, segnala instabilità emergente. | ||
| 2. **Modello ML – selezione e addestramento**: addestrare Random Forest con feature derivate da finestre scorrevoli (rolling window) di latenza, packet loss e throughput. Inserire variabili contestuali (eventi di manutenzione, condizioni meteo locali) e trasformazioni non lineari (log, differenze ordinate). Validare con cross-validation temporale (TimeSeriesSplit) e misurare precisione, recall e F1-score. Evitare overfitting con regolarizzazione e feature importance analysis. | 3. **Pipeline streaming con Kafka e Flink**: Kafka ingestisce dati da sensori di rete e firewall ogni 5 minuti. Flink esegue calcoli windowizzati (rolling avg, std dev) su metriche critiche, applica algoritmi di rilevamento anomalie basati su Isolation Forest su finestre temporali. Configurare soglie dinamiche con baseline adattive: soglia = media + 2.5× deviazione storica. Alert inviati via SMS e email solo se superate. | |
| 4. **Validazione e feedback loop**: ogni mese confrontare predizioni con incidenti reali. Usare matrice di confusione per calcolare tasso falsi positivi (FPR) e copertura predittiva. Aggiornare modello con dati corretti e retraining automatico su pipeline CI/CD. Monitorare drift dei dati con test statistici (Kolmogorov-Smirnov). | ||
| 5. **Auto-remediation**: quando un’interruzione minore viene rilevata (es. perdita di segnale satellitare per <5 min), Flink esegue script di riavvio automatico del gateway o riindirizzamento su link di backup. In caso di eventi critici (>10 min di downtime), attivare playbook di escalation verso team operativo con ticket Jira precompilati. Implementare rollback automatico in caso di fallimento, con log dettagliati per audit. |